
为智能体AI而生:全新骁龙移动平台携全球最快CPU开启双旗舰新篇章
引言:旗舰逻辑变了
过去十几年,移动芯片的竞争叙事始终围绕"峰值性能"展开——谁的主频更高、谁的跑分更亮眼。但2026年的旗舰之争,命题已经彻底改变:当用户的每一次请求都被拆解成一连串跨应用、跨模型、需要持续推理的任务流,手机SoC需要的不再是单点性能的暴力堆砌,而是一套为"智能体AI"从头设计的全新架构。
这正是高通在2026骁龙峰会上要给出的答案。在峰会前,高通就已经通过一系列博客内容揭开了下一代旗舰移动平台的神秘面纱:全新架构、全球最快的移动CPU。平台内CPU、GPU 和 NPU 均进行了面向 AI 工作负载的专门升级——一句话概括,这是一颗为智能体AI而生的新平台。
更值得注意的是,高通这一次没有只拿出一个答案,而是拿出了两个:首次在旗舰产品线同时推出两款骁龙8至尊版平台,以"双旗舰"策略重新划分旗舰市场的势力范围。
双旗舰定位:一次发布,两种旗舰哲学
"双旗舰"是高通为骁龙旗舰产品线开启的全新篇章,也是本次更新中最引人注目的战略动作。两款平台各有分工:
第六代骁龙8至尊版:定位"普及型旗舰",在旗舰级性能和先进智能能力之间实现出色平衡,目标是将骁龙旗舰体验带给生态系统中更广泛的终端,满足消费者对旗舰体验的需求。
第六代骁龙8超级至尊版:定位"巅峰旗舰",代表骁龙创新的又一次突破,专为最先进的AI工作负载和定义智能体时代的全新体验而打造,瞄准AI、游戏、影像、视频等各技术领域的顶尖体验。
用通俗的话讲:至尊版负责让旗舰体验"百花齐放",超级至尊版负责把技术天花板"再顶高一截"。从已经披露的信息看,两者在封装技术上也有所不同——超级至尊版采用了更先进的PoP封装技术,以获得更出色的持续性能和整体算力表现,提升散热效率和热设计余量,从而支撑更重载的长时间高负载场景。
这种双线并行的打法,本质上是应对旗舰终端市场的分化:一边是追求极致体验的Ultra机型用户,一边是主流旗舰的庞大基本盘。一款平台通吃两端的时代过去了,双旗舰让OEM厂商在产品定义上拥有了更大的灵活性。
创新架构:为智能体AI重新设计的计算体系
第六代骁龙8超级至尊版的设计,都围绕一个核心命题展开:让更多AI工作负载能更靠近处理器侧运行。这背后是行业性的现实约束——内存资源始终紧张,如果每一次AI计算都依赖大量DDR数据搬运,时延、功耗和带宽都会成为瓶颈。高通的解法是从架构层面"重构数据的流向",让数据尽可能驻留在离计算单元更近的位置。
由此,这颗芯片形成了智能体时代独有的分工图景:传感器中枢负责不间断的环境语音感知;Oryon CPU负责指挥、规划、推理并协调整个工作流程,在需要调用云端API时快速完成调度和路由;面对多种模型在终端侧同时运行的混合场景,Hexagon NPU或Adreno GPU可以协同支撑AI推理。SoC的每一个模块各司其职,共同构成一台"智能体引擎"。
全球最快CPU:Qualcomm Oryon 达成5GHz里程碑
平台的核心技术之一,是全新Qualcomm Oryon CPU。它有两个重磅升级:
其一,它是全球最快的移动CPU,也是首个最高主频达5GHz的移动CPU。 超级内核最高主频高达5GHz,性能内核最高主频也达到4GHz。值得强调的是,5GHz并非仅靠先进制程堆出来的数字,而是从微架构、落地方案到CPU子系统的完整定制化设计——每个组件都经过精细调校。当然,高通也明确指出:主频并非性能的全部,真正的价值在于频率与出色IPC(每时钟周期指令数)的结合,让性能优势在应用秒开、网页流畅、游戏与内容创作紧跟操作节奏等实际场景中充分兑现。
其二,全新Qualcomm Oryon FlexCache可扩展缓存架构。 这是本次CPU升级中技术含金量最高的部分。FlexCache支持异构计算核心——超级内核与性能内核——访问同一个可动态调整资源分配的缓存池。当高负载任务需要更强算力时,超级内核可以充分利用几乎整个缓存池,让更大的工作集得以驻留在缓存中,无需频繁回写系统内存,峰值性能得以持续释放。
对智能体AI而言,这项设计的意义尤为关键:智能体并不是执行单一任务,而是管理一连串任务,频繁迁移线程、调用运行在不同核心上的工具。传统架构下,任务在核心间迁移意味着数据要重新加载;而FlexCache让超级内核和性能内核能够访问同一个异构缓存池,使相关数据在任务切换的过程中继续保留在在缓存中。在行业普遍面临内存压力的背景下,这种"减少DDR访问"的设计思路,直接决定了智能体多步任务能否做到更快、更无缝、更流畅。
Hexagon NPU:撑起端侧大模型的专用AI引擎
如果说CPU是智能体的"指挥官",Hexagon NPU就是执行推理的"主力军"。全新Hexagon NPU带来两项关键创新:
全新Element Accelerator:专为当今生成式AI和智能体AI的Transformer工作负载打造,结合向量计算单元与标量计算单元,加速大模型中最关键的运算,让智能体更快响应、更高效推理。
共享内存扩容50%:让模型状态、上下文信息和KV-cache数据存储在更靠近加速器的位置,大幅减少访问外部DDR的次数——更低的时延、更少的内存读取,同时为其他工作负载释放宝贵的内存带宽。
新平台的AI底座还有两项重要特性:其一,支持300亿参数量级的混合专家(MoE)模型——一个300亿参数的MoE模型,每次生成一个词元,仅需激活约30亿个经路由选中的参数,配合对专家模块从闪存加载至内存过程中进行智能管理的机制,以更低的功耗和内存需求实现大模型级别的体验;其二,多精度策略,支持INT2、INT4、INT8、FP8、FP16等多种数值精度。对基于INT4的模型可实现最高50%的预填充性能提升。规模更小的高效模型承担日常端侧任务,更大的模型在复杂任务时才被调用——这种灵活的精度组合,正是智能体"多模型协同调度"的架构前提。
平台级的环境感知能力同样在升级:全新高通传感器中枢搭载两个Micro NPU,性能提升高达85%、能效提升高达20%,支持高达2亿参数规模的模型,让环境语音感知在SoC其余模块空闲时依然持续在线;配合全新升级的"个人记录"(Personal Scribe)功能,构建持续积累的个人上下文层,让智能体真正"认识"它的用户。
Adreno GPU:AI第 一次被"焊"进图形管线
这一代Adreno GPU完成了架构层面的重大突破,图形性能与能效均实现极大代际跃升:
三切片架构再提速:每个切片的频率提升250MHz,持续增强渲染能力。
18MB Adreno独立高速显存(HPM):一种专用片上图形存储器,可理解为"可配置的图形工作空间",存储渲染目标、深度与颜色缓冲区、中间纹理等数据,让相关数据更靠近GPU、减少DDR访问次数,实测带来12%的功耗降低。
全新Adreno Matrix Cores:这是Adreno发展历程中的首次突破,也是高通AI路线图的重要里程碑——针对AI负载打造的GPU专用核心,让神经网络计算无需离开图形渲染管线即可完成。至此,从NPU、CPU到GPU,平台内每个核心引擎都获得了Matrix加速能力。
Adreno Matrix Cores带来的直接成果,是Adreno Neural Fusion——一项AI驱动的渲染技术,将神经处理、AI超级分辨率和AI帧生成整合进统一的图形管线,在呈现更高画质的同时降低渲染开销与功耗,大幅减少传统超分方案的伪影与细节抖动问题。它还是行业首个在主流游戏引擎上落地商用的移动端AI超分技术,现已支持Unity与虚幻引擎,首批将与18款手机游戏开展合作,游戏工作室“开箱即得”画质与帧率提升,无需自研方案。
值得一提的是,Adreno Matrix Cores本质上是面向AI工作负载的通用计算核心,除图形增强外,开发者也可以利用它们运行其他通用AI任务——这为图形管线之外的AI创新预留了想象空间。
Spectra ISP:每一颗像素都携带16位AI数据
第六代骁龙8至尊版采用Qualcomm Spectra ISP,且在超级至尊版上,ISP的定位被彻底改写:它不再仅仅是影像管线,而是与NPU深度耦合、在拍摄当下即应用智能处理的"AI影像引擎"。两大跃升:
视频吞吐量提升至原来的4倍:用户首次能够在商用终端上拍摄8K 60fps视频,超级慢动作规格也升级至4K 240fps;同时支持在中国颇受欢迎的新一代视频编码标准VVC,从而进一步降低视频流编解码功耗。
每像素16位AI数据:NPU链路升级后,ISP可为每个像素分配16位AI信息,信息量达到前代的256倍。配合智能像素控制(Intelligent Pixel Control)等AI影像能力,可以实现跨帧持续追踪拍摄对象、获得更丰富的语义分割——ISP对场景中每个细节的理解深度,都是前所未有的。
连接与封装:为6G和持续性能埋下伏笔
旗舰体验从来不只有计算。连接方面,新平台搭载高通X105 5G调制解调器及射频系统——全球首款面向3GPP Release 19实现就绪的调制解调器及射频系统,为6G奠定基础;高通FastConnect 8800则是高通的Wi-Fi 8解决方案,四合一集成芯片,首款采用4x4 Wi-Fi射频配置的移动解决方案,并支持最新Thread,让手机有能力成为智能家居中枢。
封装层面,高通带来了Offset PoP创新:将封装内存移到一侧,为处理器区域开辟专用散热路径。在游戏、视频编辑、AI处理等高负载场景中,热量得以更高效导出,为持续性能释放提供更大的热设计余量。叠加全新制程工艺(高通首款2nm芯片)带来的能效基础,这颗平台在"持续性能"上的投入,与峰值性能同样坚决。
看过信息部分,我们来看一下实际的性能跑分,以下成绩来自于高通官方的工程样机,实际的产品请以最终量产机的实际表现为准,性能指标仅供大家参考。
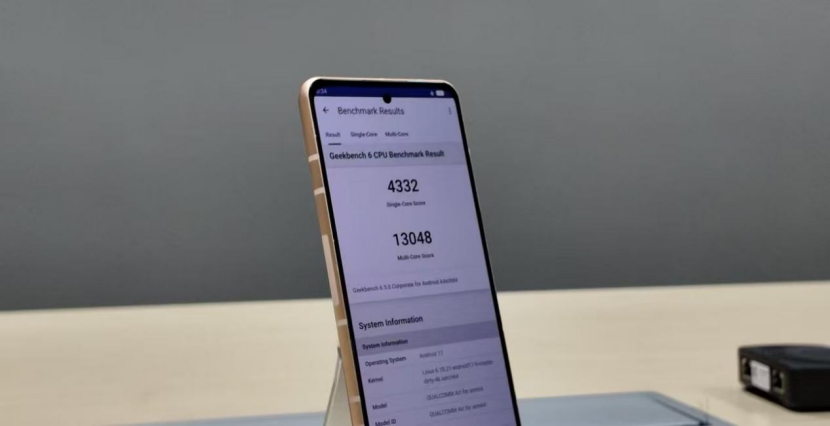
第六代骁龙8超级至尊版的GeekBench 6单核跑分为4332,多核跑分为13048,较上代平台,在CPU单核与多核性能方面均有更出色的表现。
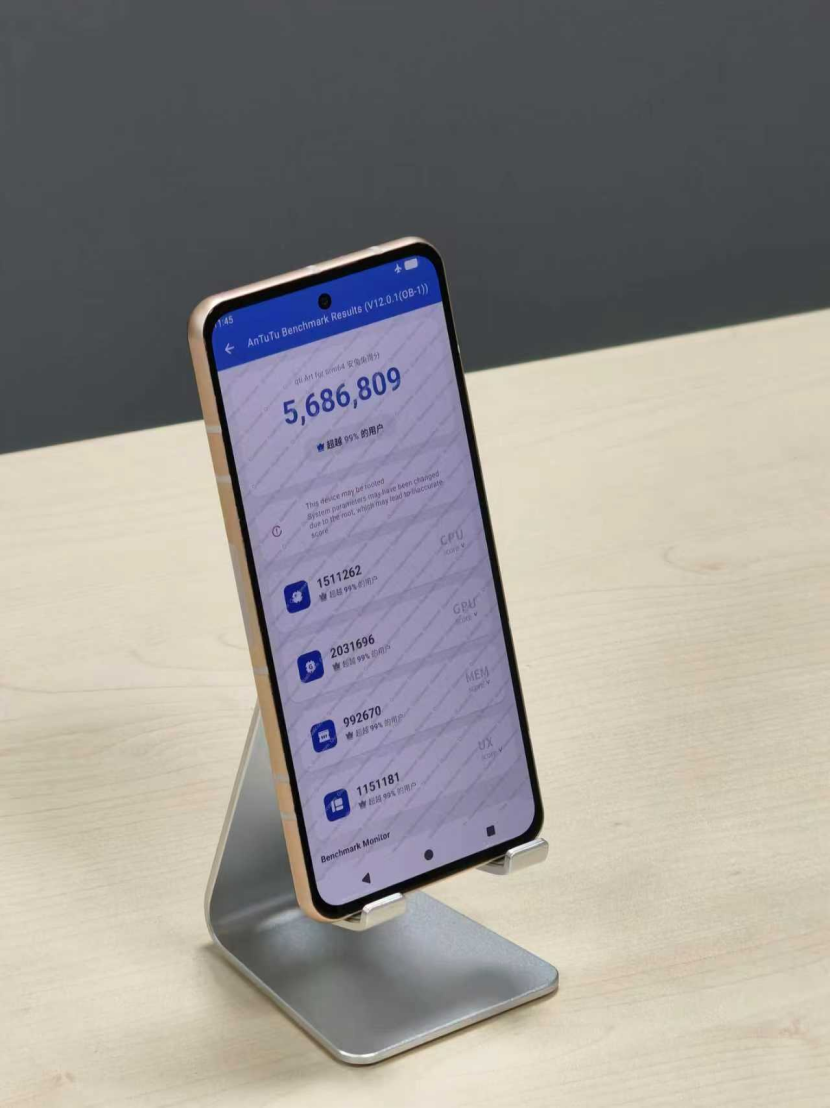
新版本的安兔兔测试中,第六代骁龙8超级至尊版综合跑分来到了568W分,整体性能表现较上代平台商用机的平均水平更进一步。
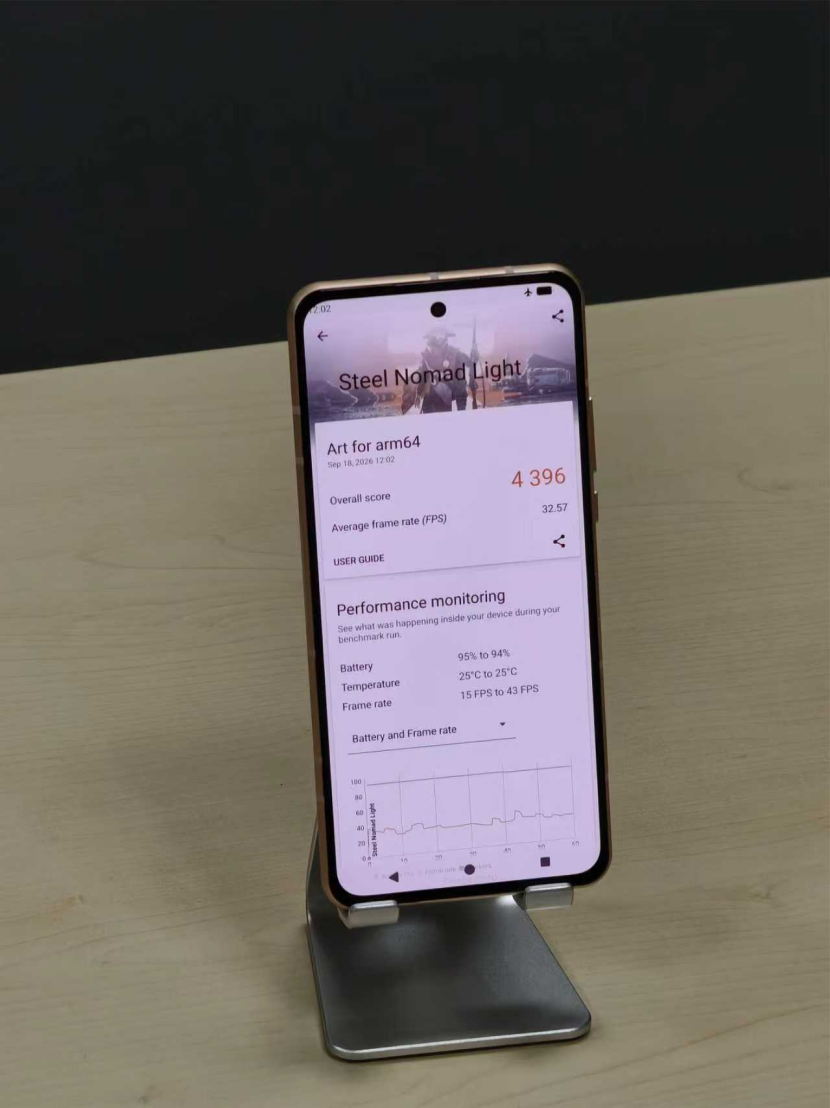
而衡量图形性能的Steel Nomad Light测试中,第六代骁龙8超级至尊版的综合跑分来到了4396,展现出更强的图形处理能力。
综合来看,这次第六代骁龙8超级至尊版的实际性能表现相对于上代依旧有两位数的大幅性能提升,性能表现毫无疑问是现阶段顶级旗舰的水准,再次稳坐移动平台的旗舰宝座。
结语:当"智能体手机"从概念走向硬件
回看这颗平台,你会发现高通的答案高度自洽:智能体AI需要任务在核心间频繁迁移,于是有了FlexCache;需要端侧跑更大的模型,于是有了Element Accelerator、扩容50%的共享内存和MoE支持;需要AI融入每一项体验,于是NPU、CPU、GPU乃至传感器中枢、ISP协同工作,共同支持智能体体验;需要这一切长时间持续运行,于是有了Offset PoP、Adreno HPM和2nm工艺。
旗舰移动平台的历史上,还从未有一代产品如此彻底地围绕一个应用范式重构整个芯片架构。第六代骁龙8超级至尊版能否成为"史上最强骁龙",或许要等厂商新品发布后说话,但可以确定的是——它是有史以来最像"智能体手机心脏"的一颗骁龙。至于双旗舰策略能否帮助高通在旗舰市场的分化时代左右逢源,答案将在9月23日骁龙峰会正式揭晓,也将由搭载这两款平台的下一代旗舰手机逐一书写。

