
内存直接叠在芯片上:高通 HBC 验证跑通,AI250 有效内存带宽 133TB/s
高通 11 月 2 日宣布,初代高带宽计算(HBC)技术已在圣迭戈实验室完成硬件验证,完整读写与近存计算能力均通过实测;按官方口径,搭载该技术的 AI250 加速卡有效内存带宽可达 133TB/s,计划 2027 年上半年出样。
先看清“验证”二字
这次公布的关键词是实验室验证。高通在自有实验环境中跑通了 HBC 的完整读写链路,并实际执行了近存计算负载,说明“内存在上、计算单元在下”的堆叠封装在电气与功能层面已经可行。从验证到客户送样、再到规模量产,中间还隔着封装良率、散热、可靠性与软件适配等环节,现阶段不宜理解成产品已经就绪。
HBC 与 HBM 差在哪
传统高带宽内存(HBM)的做法是:把多颗 DRAM 芯片用硅通孔(TSV)垂直串起来,再经硅中介层与处理器并排封装。HBC 换了两件事——堆叠的是多层 LPDDR,位置挪到了计算芯片正上方;层与层之间同样靠 TSV 互连,最底部是一颗负责近存计算的计算芯片。
介质与位置的改变,带来的是取向差异。LPDDR 供应链成熟、单位容量功耗较低,适合追求每瓦带宽的推理负载;HBM 则在带宽与容量上积累深厚。两者更像并行路线:HBC 试图用低功耗内存加短距离互连,换一个能效更优的解,而不是简单替换现有方案。
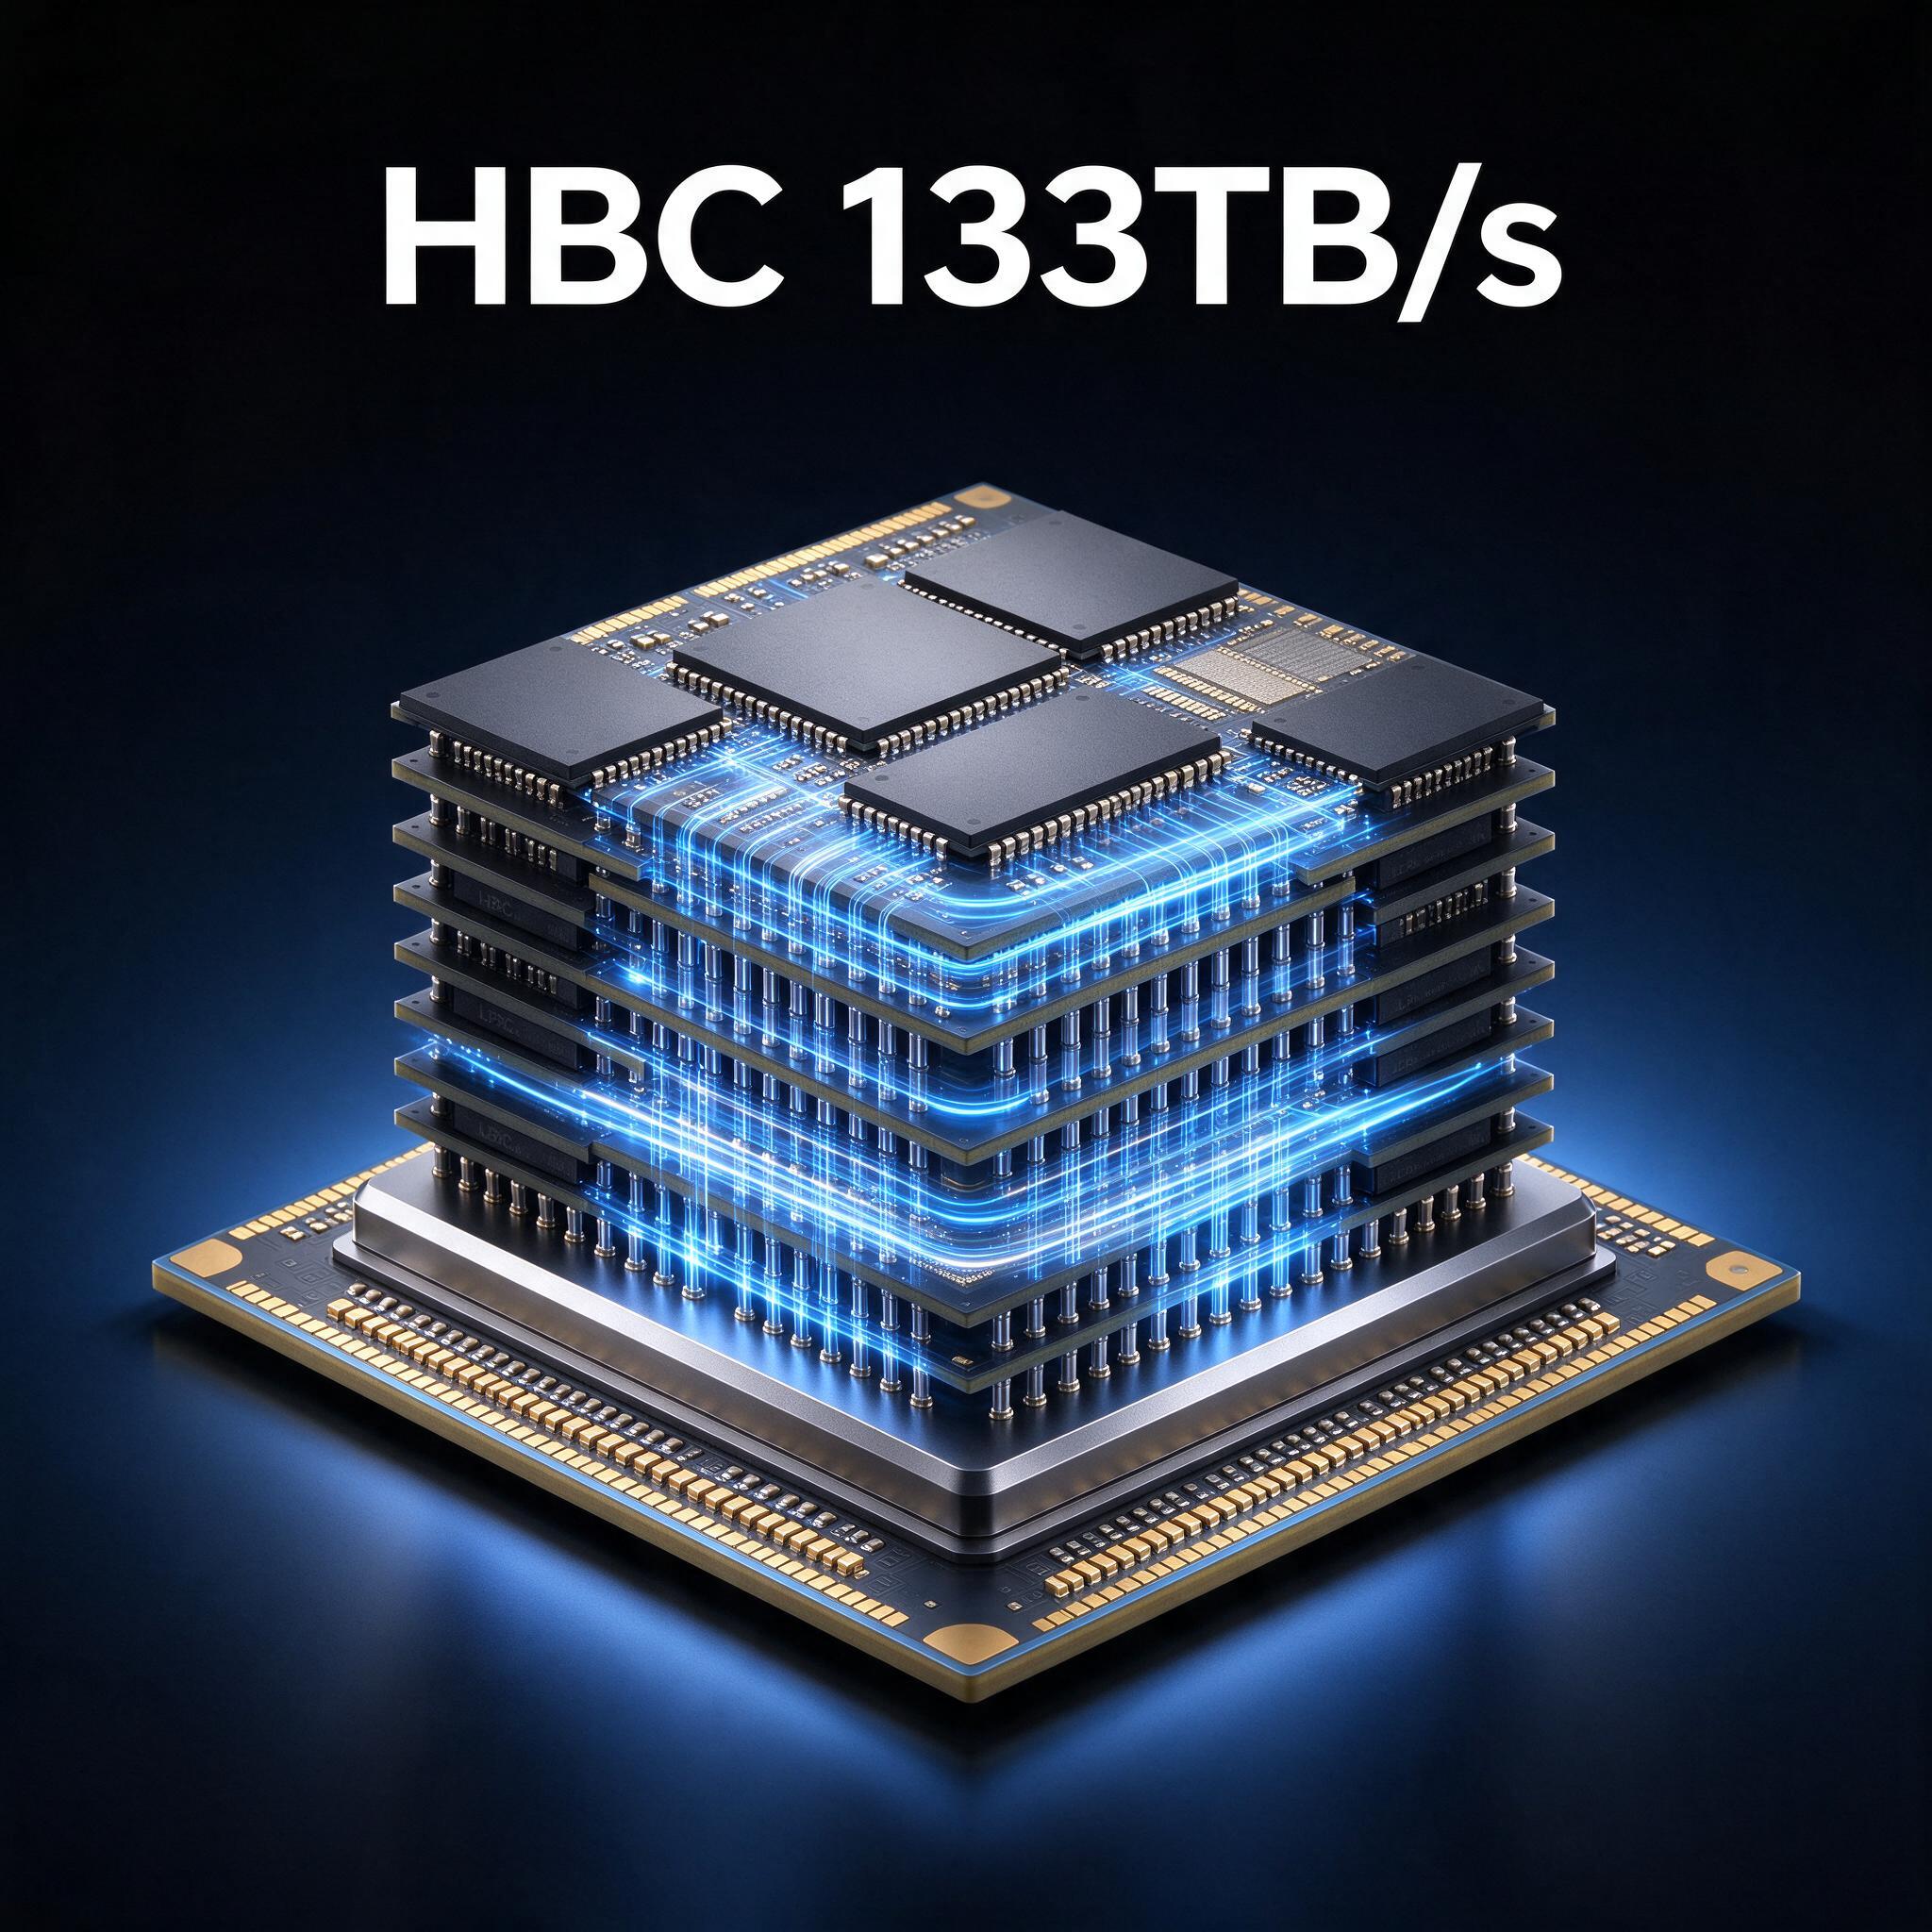
图:多层内存堆叠与计算芯片的三维示意(AI 生成)
近存计算把“搬运”缩短到微米级
高通此前公布的技术方案显示,计算单元直接放在内存堆叠下方,数据传输距离从传统架构的数厘米缩短至数微米。对 AI 推理这类频繁搬运权重与激活值的负载,距离缩短意味着更低的延迟与更少的搬运功耗,这正是“近存计算”被反复提及的原因。
高通给 HBC 设定的目标是每瓦带宽达到传统 HBM 方案的 6 倍。此次验证使用的早期样品是两层 DRAM 堆叠,高通公布的测试结果显示其每瓦带宽超过 HBM4 的 5 倍,但尚未摸到 6 倍;正式产品预计采用四层堆叠,能效还有继续上探的空间。
133TB/s 该怎样对比
高通给出的数字是“有效内存带宽”:初代 HBC 方案让 AI250 加速卡达到 133TB/s,而采用 LPDDR5X 的上一代 AI200 是参照基准,前者为后者的 18 倍。再往后,计划采用第二代 HBC 的 AI300,官方设计目标是 AI200 的 54 倍。
需要注意口径:133TB/s 是高通针对自家产品给出的设计数值,并非第三方实测,也不等同于具体模型在真实业务中的有效吞吐;“有效”是高通自己给出的定义口径,与实际可达带宽并不完全等价。跨方案比较时,测试条件同样要看清楚。
时间表与待解的问题
按高通 2026 年 6 月公布的数据中心路线图,AI250 搭载初代 HBC,AI300 使用第二代 HBC;AI250 的出样节点定在 2027 年上半年。对数据中心客户而言,出样之后还要经历验证、适配与部署周期,真正的考验是软件栈能否把带宽优势转化为推理吞吐。
在内存供给成为行业关注点的背景下,用 LPDDR 堆叠换取带宽与能效,确实提供了一条不同的供给路径。但容量上限、封装良率与生态成熟度,仍要等产品落地后才有答案。
关键词: 高通、HBC、AI250、内存带宽、近存计算

